
AI编程
Qwen3.8 显存要求:27B 用哪个量化档
对照 Unsloth 官方硬件门槛表评估 Qwen3.8-27B 显存与内存需求:4-bit 需 16-19GB,1-bit 至 3-bit 需 7-14GB,高精度档位需 23-56GB。按总内存选择匹配量化档位。
Qwen3.8 显存需求直接决定 27B 模型在本地设备上的可用量化档位。选档依据来自 Unsloth 的 Qwen3.8 指南 发布的硬件门槛表,权重文件发布于 unsloth/Qwen3.8-27B-GGUF 仓库。本篇核对各量化档位对应的显存与系统总内存门槛,Mac 系统的本地安装与环境编译流程见 在 Mac 上用 Unsloth 本地跑 Qwen3.8-27B。
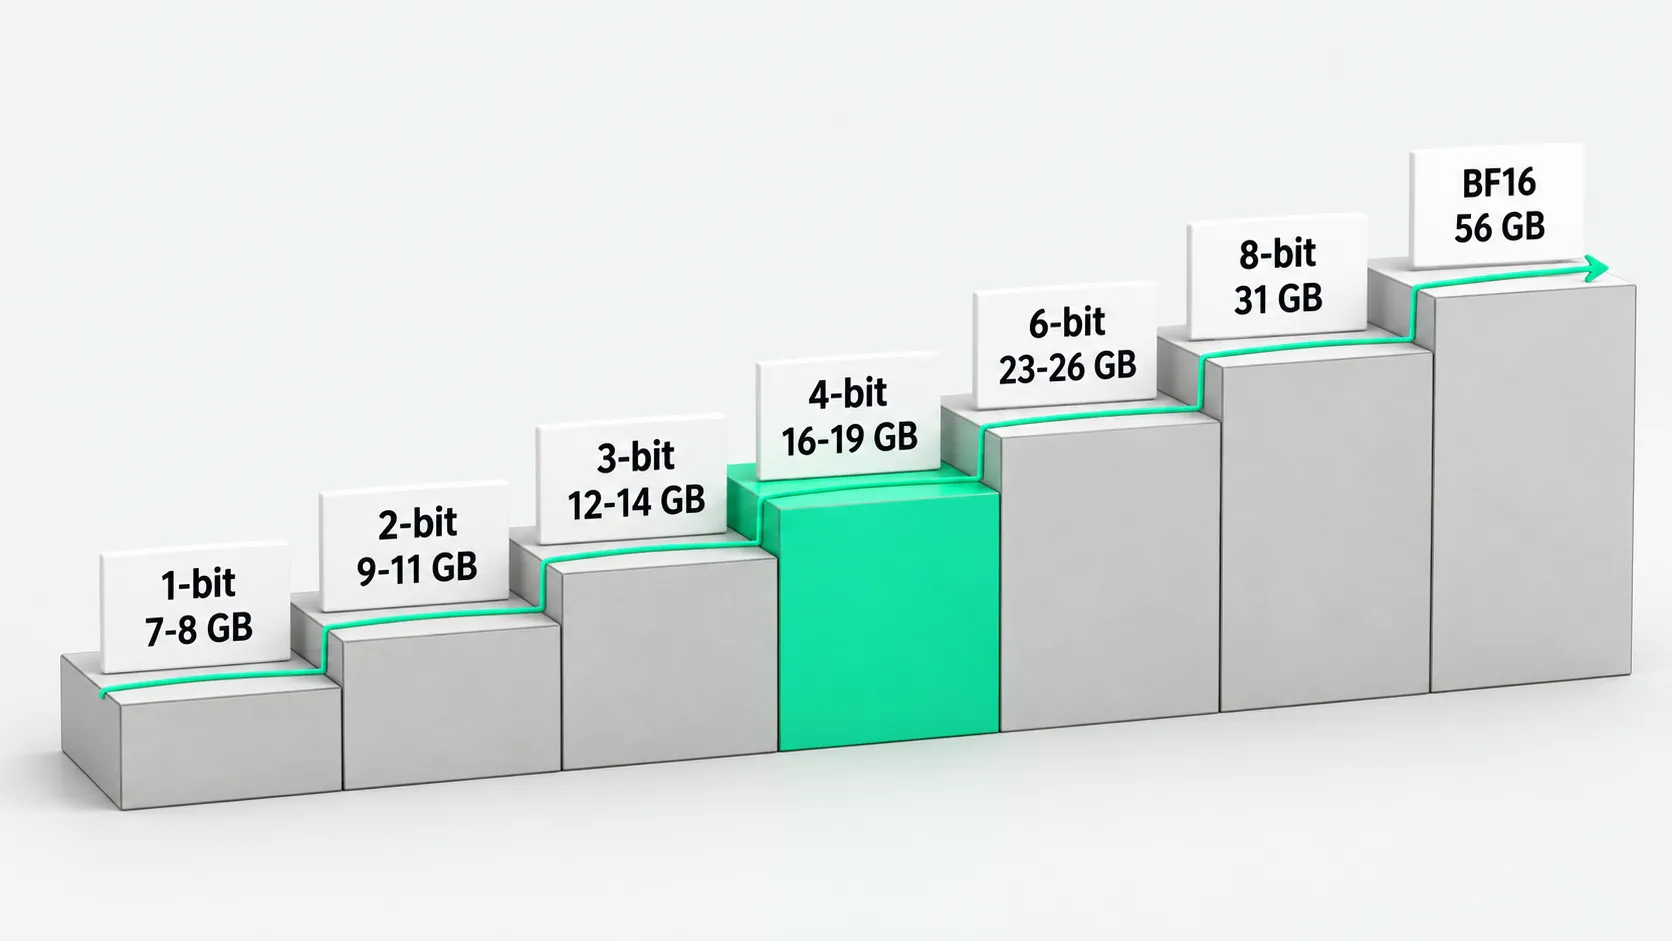
官方显存门槛表
| 量化档位 | 1-bit | 2-bit | 3-bit | 4-bit | 6-bit | 8-bit | BF16 |
|---|---|---|---|---|---|---|---|
| 门槛要求 | 7-8 GB | 9-11 GB | 12-14 GB | 16-19 GB | 23-26 GB | 31 GB | 56 GB |
数据来自 Unsloth 的 Qwen3.8 指南。表中数值表示运行对应档位所需的主机总内存下限。统计口径为总内存(独立显卡的 RAM+VRAM,或 Apple Silicon 的统一内存)。在纯 GPU 推理模式下,数值对应独立显存;在混合卸载模式下,对应系统物理内存与显存的分配总额;在 Mac 设备上,对应整机统一内存。
按机器总内存怎么选档
- 16-19GB 内存选 4-bit:Qwen3.8-27B 本地运行的常见基准配置为 17GB RAM/VRAM 环境。4-bit 量化档位覆盖 16-19GB 显存区间,适用于 RTX 5080、RTX 4090 或配置 24GB 统一内存的 Mac 主机。
- 内存更小选 1-bit 至 3-bit:可用内存处于 7-14GB 区间时,可根据显存上限下调至 1-bit(7-8GB)、2-bit(9-11GB)或 3-bit(12-14GB)。根据 2026 年 8 月 19 日更新,Unsloth GGUF 采用 Unsloth Dynamic V3.0,在相同体积下提供比常规量化约高 10% 的准确率。
- 接近原精度选 6-bit 或 8-bit,原精度选 BF16:硬件显存充裕时,可选择 6-bit(23-26GB)、8-bit(31GB)或 BF16(56GB)。搭载 Blackwell 架构的 24GB VRAM 显卡还可运行 NVFP4 档位,推理速度约为 BF16 的 1.5 倍。
- 多 Token 预测需预留 1-2GB:Qwen3.8-27B 原生支持 262,144 上下文长度(可通过 YaRN 扩展到 1M)。若推理引擎开启多 Token 预测(MTP),在上述权重显存之外需额外预留 1-2GB 显存余量。
和「在 Mac 上跑通」那篇怎么分工
- 门槛篇(本篇):核对 27B 各量化档位对独立显存与统一内存的硬门槛,用于装机评估与选档决策。
- 实操篇(Mac 篇):承接 Apple Silicon 上的环境配置、桌面端操作、llama.cpp 编译与 Metal 运行参数,本篇不重复具体的安装命令与采样配置。
本机内存不够时调用 API
白泽 API 提供兼容 OpenAI 格式的模型接口。本地物理内存或显卡显存低于 16GB 时,可以通过它调用 Qwen 3.8 Max,不用在本机加载 27B 权重。模型 ID 和价格以 模型广场 为准。
若计划采购高显存硬件在本地部署 27B 开展垂直业务微调,在配置硬件前,需先核对业务事实是否需要频繁更新,并评估知识库检索方案,见 垂直行业模型微调之前,为什么先接企业知识库。
Qwen3.8 显存:常见问题
运行 Qwen3.8-27B 时,显存门槛的统计口径是独立显存还是包含系统内存?
Unsloth 官方硬件门槛表以总内存(RAM+VRAM 或 Apple Silicon 的统一内存)为口径。在独立显卡环境下,若模型权重完全加载进 GPU 运行,16-19GB 门槛对应独立显存;若采用 CPU 与 GPU 混合分层卸载,则对应系统内存与显存之和。统一内存架构下,整个系统共享同一块内存空间,系统自身与常驻进程仍需占用基础空间。
在 16-19GB 显存档位开启长上下文或 MTP 时,会不会超出显存限制?
4-bit 量化档位覆盖 16-19GB 显存区间。根据 Unsloth 说明,启用多 Token 预测(MTP)需要预留 1-2GB 显存余量。Qwen3.8-27B 原生支持 262,144 上下文(可经 YaRN 扩展至 1M),长上下文同样会占用显存空间。在 16GB 显存或 24GB 统一内存设备上运行,需预留 MTP 与上下文空间,避免长文本输入导致显存不足。
显存不足以支撑 16GB 时,选择极低 bit 的 27B 量化档还是切换到小参数模型?
Unsloth 官方提供了 1-bit(7-8GB)、2-bit(9-11GB)与 3-bit(12-14GB)量化档位,并在 2026 年 8 月 19 日更新中采用 Unsloth Dynamic V3.0,同尺寸下准确率较常规量化约高 10%。对于 8GB 或 12GB 显存环境,选用 27B 量化档可以在单卡加载 27B 模型,但官方没有公布各档的质量对比;需要稳定质量时优先 4-bit 及以上。如果业务需要完整精度而显存不够,可以改用云端 API。