
AI编程
Codex 配 subagent:判断力留给主线程,重复交给便宜档
截至 2026 年 10 月,Codex 文档推荐 GPT-6 Astra、GPT-6.1 Sol、GPT-6 Luna 三个模型,并支持给不同角色的 subagent 配不同模型和推理档位。这篇笔记整理一套按文档能跑的配置:主线程用 Sol 或 Astra,范围明确的重复子任务交给 Luna;附模型选择的生效顺序,以及推理档位 ultra、max、xhigh 要看模型支不支持。
本文 2026 年 8 月初稿时,OpenAI 当年 7 月发布的 GPT-5.6 分 Sol、Terra、Luna 三档。2026 年 9 月下旬 Codex 换到 GPT-6 家族:9 月 25 日 Codex CLI 0.157.0 加入 GPT-6 Sol 和 GPT-6 Luna,9 月 29 日上线 GPT-6.1 Sol。截至 2026 年 10 月,Codex 文档列出的推荐模型有三个:GPT-6 Astra 能力最强;GPT-6.1 Sol 接近 Astra、成本更低,是文档给多数任务的起点;GPT-6 Luna 最快最省,适合范围明确、可重复、走量大的任务。GPT-5.6 三档在过渡期内仍可选。Codex 支持给不同角色的 subagent 配不同模型和推理档位,所以要回答的问题是:每个角色配多重的判断力。答案写在配置文件里。
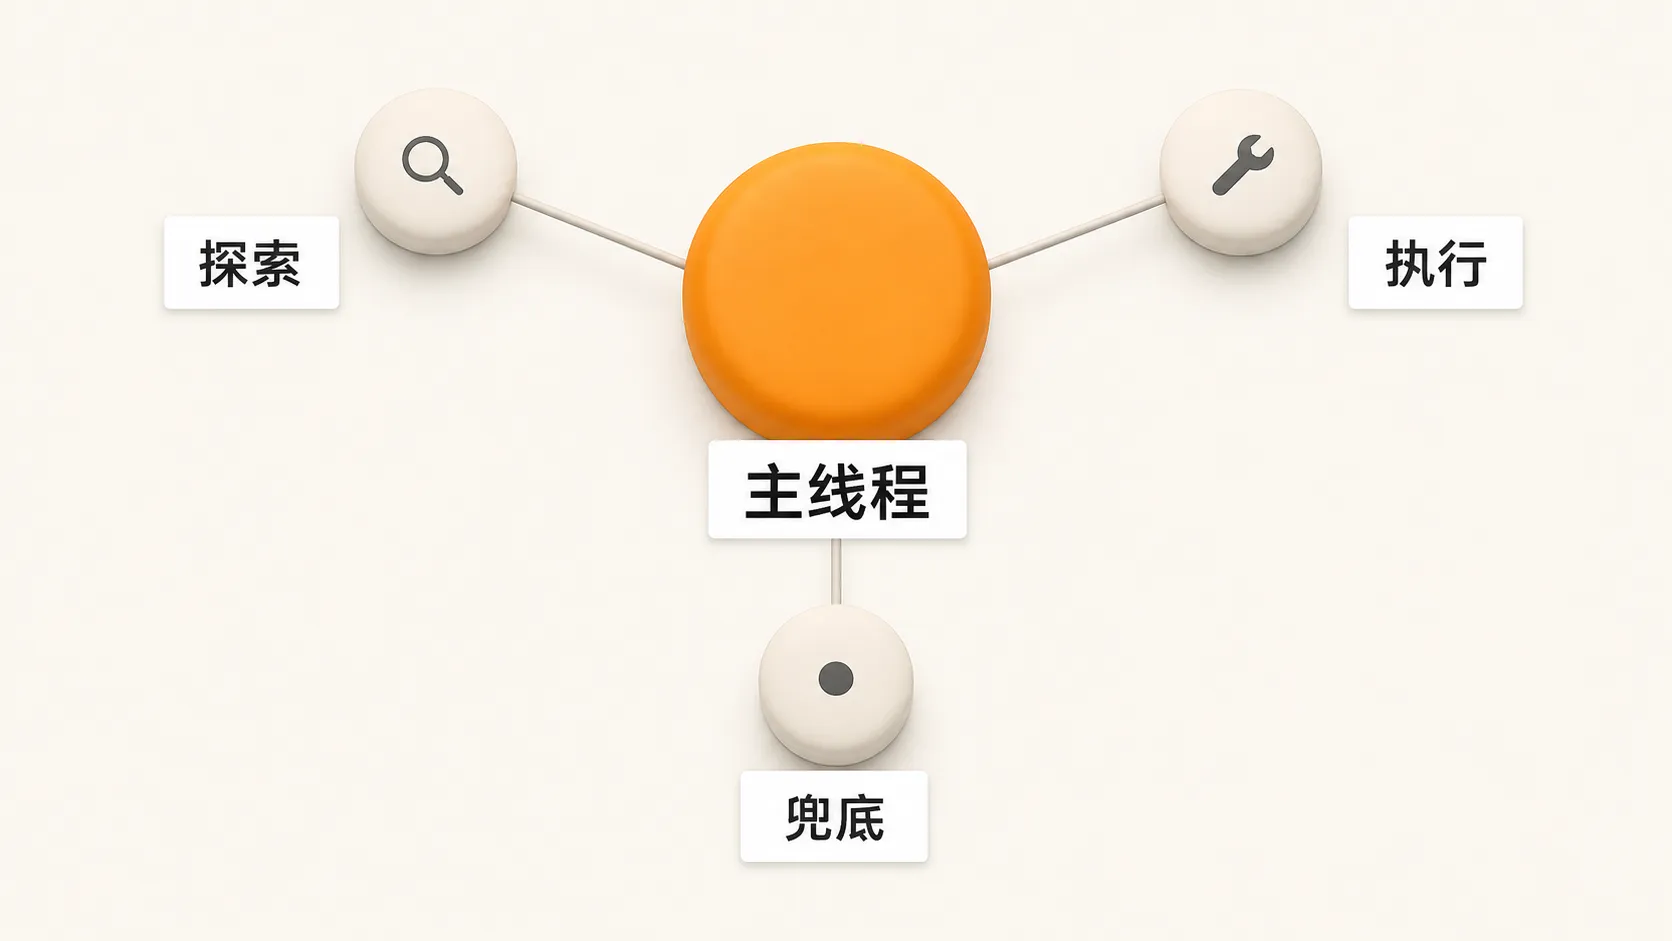
主线程管判断,子任务跑执行
主线程负责范围界定、任务拆解、结果整合。这几步判断错了,后面所有子任务都在错误的前提上干活,所以主线程配最强的档位划算。子任务接范围明确、可重复、可并行的活。Codex 内置三个角色:explorer 做读密集型的代码库探索,worker 做实现与修复,default 是通用兜底。这类任务单次出错代价小,但走量大,配置时优先压速度和成本。
文档对模型的分工和这个思路一致:gpt-6.1-sol 用于需要规划、工具调用、验证的模糊多步任务;gpt-6-luna 用于范围窄、目标清楚、可重复或走量大的任务;最难的端到端任务选 gpt-6-astra。
判断「谁该有多大权限」用的是同一套逻辑:「AI Agent 安全治理要赶在扩规模之前」一文讨论生产环境里哪些决策留给人、哪些交给 Agent 自主执行。换到本地开发工具上,问题变成哪些决策留给主线程、哪些外包给便宜的执行档位。两处都按判断的成本和后果分配资源。
两层配置:全局默认 + 按角色定制
全局默认写在 ~/.codex/config.toml(个人)或仓库里的 .codex/config.toml(项目)。项目层只在你信任该项目时才加载;多个项目层从项目根目录往当前目录排,离当前目录最近的优先。
model = "gpt-6.1-sol"
model_reasoning_effort = "high"

[agents]
default_subagent_model = "gpt-6-luna"
default_subagent_reasoning_effort = "high"
max_concurrent_threads_per_session = 6
max_concurrent_threads_per_session 限制同时打开的子任务线程数,不含主线程;不写由 Codex 决定默认值,旧配置里的 max_threads 是它的别名。最难的任务可以把主线程的 model 换成 gpt-6-astra。
按角色定制用独立的 TOML 文件,放进 ~/.codex/agents/(个人)或 .codex/agents/(项目),每个文件定义一个 agent。name、description、developer_instructions 三个字段必填。模型相关的可选字段是 model、model_reasoning_effort、model_reasoning_summary、model_verbosity。
.codex/agents/luna-worker.toml:
name = "luna_worker"
description = "范围明确、可重复、可并行的子任务,优先派给它。"
developer_instructions = """
按分配到的任务范围精确执行。
只返回结果或简要证据,不要扩大范围。
"""
model = "gpt-6-luna"
model_reasoning_effort = "high"
沙箱和审批不在 agent 文件里配。文档写明:子任务继承父会话当前的沙箱和审批设置,sandbox_mode、approval_policy、model_provider、mcp_servers 写进 agent 文件也不会覆盖父会话。要收窄某个 agent 的能力,把 features.shell_tool 等功能开关设为 false。
改完配置是否需要重启 Codex 或开新会话,截至 2026 年 10 月文档未提及。
生效优先级
子任务的 model 和推理档位按下面的顺序取值,从高到低:
- 该角色 agent 文件里写的
model/model_reasoning_effort; - spawn 时显式指定的值,例如你在提示词里要求某个模型或档位;
[agents]里的default_subagent_model/default_subagent_reasoning_effort;- 父会话(主线程)自己的模型和档位。
两条细则:spawn 或 [agents] 只指定了模型、没给档位时,用该模型自己的默认档位,不沿用父会话的档位;agent 文件只写 model 不写档位时,保留按 2–4 层解析出的档位。所选模型不支持这个档位时,要在 agent 文件里一起写 model_reasoning_effort。
想跳过配置文件、单次临时覆盖,用 CLI flag:
codex exec -m gpt-6.1-sol -c model_reasoning_effort=high "review this diff for correctness"-m 覆盖模型,-c 用 key=value 覆盖任意配置项(值按 TOML 解析),两者都只对这一次调用生效。CLI flag 在 Codex 的配置优先级里排第一,高于项目和个人的 config.toml。
一个容易配错的地方:推理档位要看模型支不支持
model_reasoning_effort 的取值由所选模型决定。文档列出的取值有 low、medium、high、xhigh、max、ultra,并写明可用档位取决于模型和客户端。GPT-6 Luna 最高支持 max,不支持 ultra。GPT-6.1 Sol 从 Light 到 Ultra 都有,max 和 ultra 是否可用取决于你的设置。ultra 会用 subagent 并行处理复杂任务的不同部分。文档列出的取值里没有 minimal。写了模型不支持的档位会怎样,截至 2026 年 10 月文档未提及。
文档给的起点:显式配置时 Luna 从 high 开始,Astra 从 low 开始,Sol 用客户端默认档位再按任务调整。不同代模型之间的档位不能一一对应,从 GPT-5.6 迁过来的配置要拿熟悉的任务重新试。
配还是不配,差的是钱和时间
所有角色都用最贵的档位,多花钱也多等时间;全用最省的档位,判断质量会下降,主线程做范围拆解和结果整合时最明显。文档还写明,每个 subagent 各自做模型和工具调用,subagent 工作流比同等的单 agent 运行消耗更多 token,所以子任务的档位直接决定这笔额外开销有多大。分层配置把贵的判断力放在主线程,把便宜的执行力放在子任务。Codex 从「个人顺手用一用」到「团队研发流程的一部分」还要跨过边界、验证、协作这几道坎,见 Codex 真正进入研发流程,需要解决哪些问题?。
执行档想换成本地开源模型时,Mac 上跑 Qwen3.8-27B 要多大内存,见 在 Mac 上用 Unsloth 本地跑 Qwen3.8-27B。